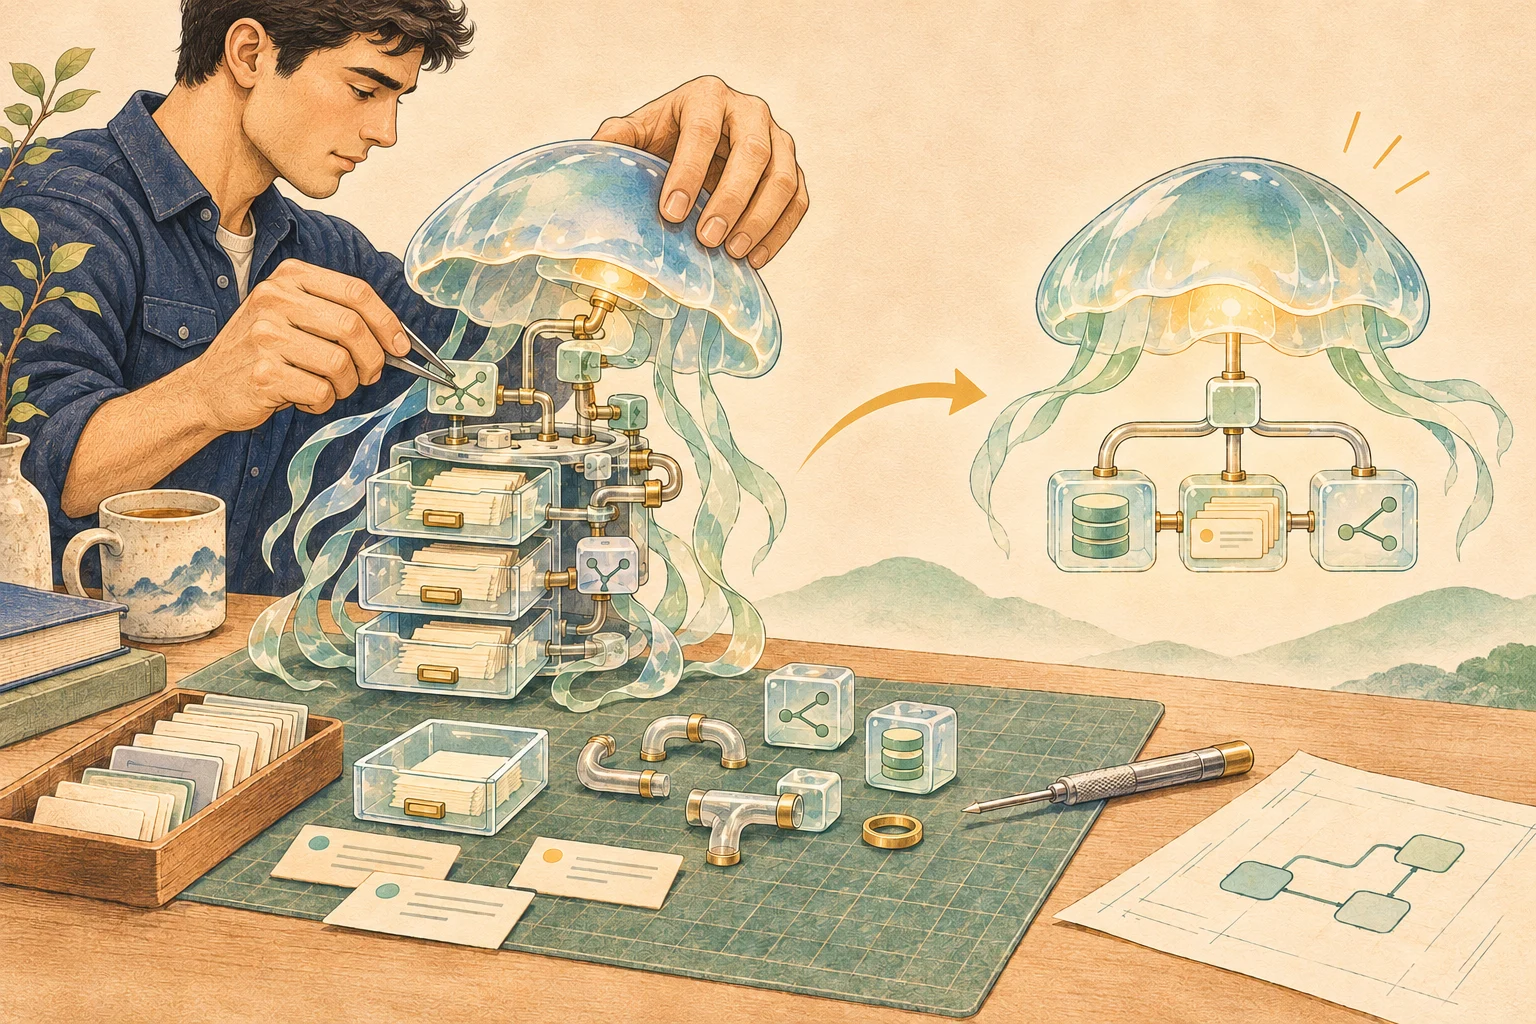
Quando consegui rodar o fluxo principal do Agent de ponta a ponta pela primeira vez, achei que a parte mais difícil já tinha terminado.
O modelo conseguia ser chamado, os dados eram gravados no banco, os vetores eram recuperados e o fluxo de trabalho chegava ao fim sem problemas. Para alguém que estava fazendo um projeto completo com LangGraph pela primeira vez, isso já era o suficiente para me deixar empolgado por um tempo.
Mas quando comecei a usar de verdade de forma contínua, os problemas foram surgindo um a um: mesmo com o checkpoint configurado, na rodada seguinte o modelo não sabia o que tinha acontecido na anterior; o fluxo de trabalho estava dividido em partes bem detalhadas, mas o estado ficava cheio de produtos intermediários que não precisavam ser salvos; o banco guardava bastante informação, mas o contexto que o modelo recebia não era necessariamente útil.
O pior era que, sempre que a demanda do produto mudava, eu primeiro tinha que explicar por que a arquitetura atual não suportava bem aquela demanda, e depois dar um jeito de encaixá-la à força.
Depois, decidi reescrever.
Para facilitar a discussão, abaixo oculto o negócio específico do projeto e o trato como um Agent conversacional que precisa acumular contexto continuamente e suportar interação em múltiplas rodadas. Este texto também não pretende listar a stack tecnológica; quero mais falar dos pontos que realmente me travaram e de como esses problemas mudaram minha compreensão sobre o desenvolvimento de Agents.
Um, eu tratei o estado do fluxo de trabalho como a memória do modelo
A arquitetura inicial era um Pipeline relativamente longo: carregar o objeto de negócio, organizar os materiais básicos, construir a query de recuperação, recuperar informações, organizar o contexto e, por fim, chamar o modelo.
Para facilitar a passagem de dados entre os nós, coloquei quase tudo o que era produzido no caminho dentro do Graph State. Resultados de consulta, query de recuperação, contexto meio organizado e até instâncias ORM do SQLAlchemy, tudo ia para dentro.
Na época, meu entendimento era simples: State não é só o dado compartilhado entre nós? Coloco lá, o próximo nó pega direto, muito prático.
Foi só quando integrei o checkpoint que o problema apareceu.
Primeiro, a serialização. Instâncias ORM não podiam ser entregues diretamente à cadeia de serialização do checkpoint daquela época como um dicionário comum. Depois, o escopo de persistência: muitos dados temporários que só eram úteis naquela execução também acabavam sendo salvos junto com o estado.
Minha primeira correção foi limpar os campos intermediários no último nó. Só depois percebi que o checkpoint registra o estado durante a execução, e limpar uma vez no final não elimina os snapshots já gravados antes.
Mas essa ainda não era a maior armadilha.
Para suportar perguntas de acompanhamento contínuas, eu queria que a segunda rodada reutilizasse diretamente o contexto salvo na primeira, economizando um processo custoso de construção. Configurei o mesmo thread_id e chamei o Graph em seguida, mas o modelo continuou como se não tivesse visto a rodada anterior.
Olhando com atenção o fluxo, a razão era bem direta: o estado foi restaurado, mas, ao chamar o modelo, eu só construí uma nova HumanMessage. As informações históricas estavam paradas no State, não foram organizadas na requisição atual, então o modelo naturalmente não as via.
O mais absurdo é que, na entrada da segunda rodada, eu ainda passei uma string vazia para o campo de contexto. A intenção era dizer "nesta rodada não recalcular", mas o efeito real foi sobrescrever o estado existente com um valor vazio...
Foi depois disso que realmente separei algumas coisas:
| Dados | Responsabilidade no sistema |
|---|---|
| Variáveis temporárias dentro do nó | Concluir o passo atual, descartar depois do uso |
| Graph State | Estado de execução transmitido entre nós e restaurado conforme necessário |
| Histórico de mensagens | Conteúdo de conversa que precisa ser mantido na interação em múltiplas rodadas |
| Entrada do modelo nesta rodada | Informação que a tarefa atual realmente precisa consumir |
O checkpoint ajuda a restaurar o estado de execução, mas quais conteúdos entram na entrada do modelo ainda precisa ser projetado por mim. Por outro lado, um State grande não significa que cada requisição vá consumir muitos tokens; só quando esses conteúdos são enviados ao modelo eles se tornam custo de entrada.
Essa diferença parece básica, mas eu só entendi depois de levar uma queda.
Também repensei a divisão dos nós. Antes, quase cada função virava um node, e depois cheguei ao outro extremo, enfiando a cadeia inteira de volta em um único node. Só continuando é que percebi que a fronteira dos nós deve seguir a necessidade de execução: passos que precisam de observação independente, roteamento por ramificação ou agendamento paralelo têm valor em ser separados; lógica de transformação usada só localmente basta como função comum.
Dois, o modelo processa devagar, e às vezes o problema que eu dei a ele era difícil demais
No início havia um fluxo de entrada que precisava recuperar registros estruturados a partir de capturas de tela.
Eu pedia ao modelo para identificar o falante, o conteúdo e o horário de cada mensagem, e então organizar tudo em um JSON estrito. Para melhorar a precisão, ainda impus várias restrições ao usuário: enviar as capturas em ordem, incluir horário, controlar a quantidade de imagens etc.
O resultado não foi bom. Em uma tentativa, duas capturas levaram cerca de dois minutos para serem processadas, e ainda havia confusão de horários, falantes trocados e conteúdo inválido.
A primeira reação, claro, foi continuar ajustando o prompt. Mas, olhando de novo o uso final, de repente percebi que eu não precisava recuperar o registro original sem perder nenhuma linha.
O que o downstream realmente precisava era: em torno de qual tema esse material gira, quais informações valem a pena manter e em que contexto elas ocorreram.
Então mudei a granularidade dos dados de "registro original linha a linha" para "informação organizada em torno de um tema". O modelo deixou de assumir a tarefa de reconstruir completamente o registro, e a recuperação posterior também não precisava mais remontar a semântica a partir de um monte de mensagens dispersas.
Claro que essa solução tinha um custo na época: eu exigia que o material enviado pelo usuário em uma única vez pertencesse ao mesmo tema, o que na prática devolvia parte do trabalho de segmentação ao usuário. Isso aliviava a carga de processamento, mas ainda não resolvia completamente a experiência de entrada.
Esse episódio me fez criar o hábito de, antes de otimizar o modelo, fazer duas perguntas: de que informação a funcionalidade final realmente precisa? A granularidade que estou pedindo ao modelo agora excede o uso real?
O banco conseguir armazenar o registro original não significa que o modelo precise reconstruí-lo linha a linha; o modelo conseguir produzir uma estrutura complexa também não significa que o produto precise que o usuário espere ele preencher essa estrutura inteira.
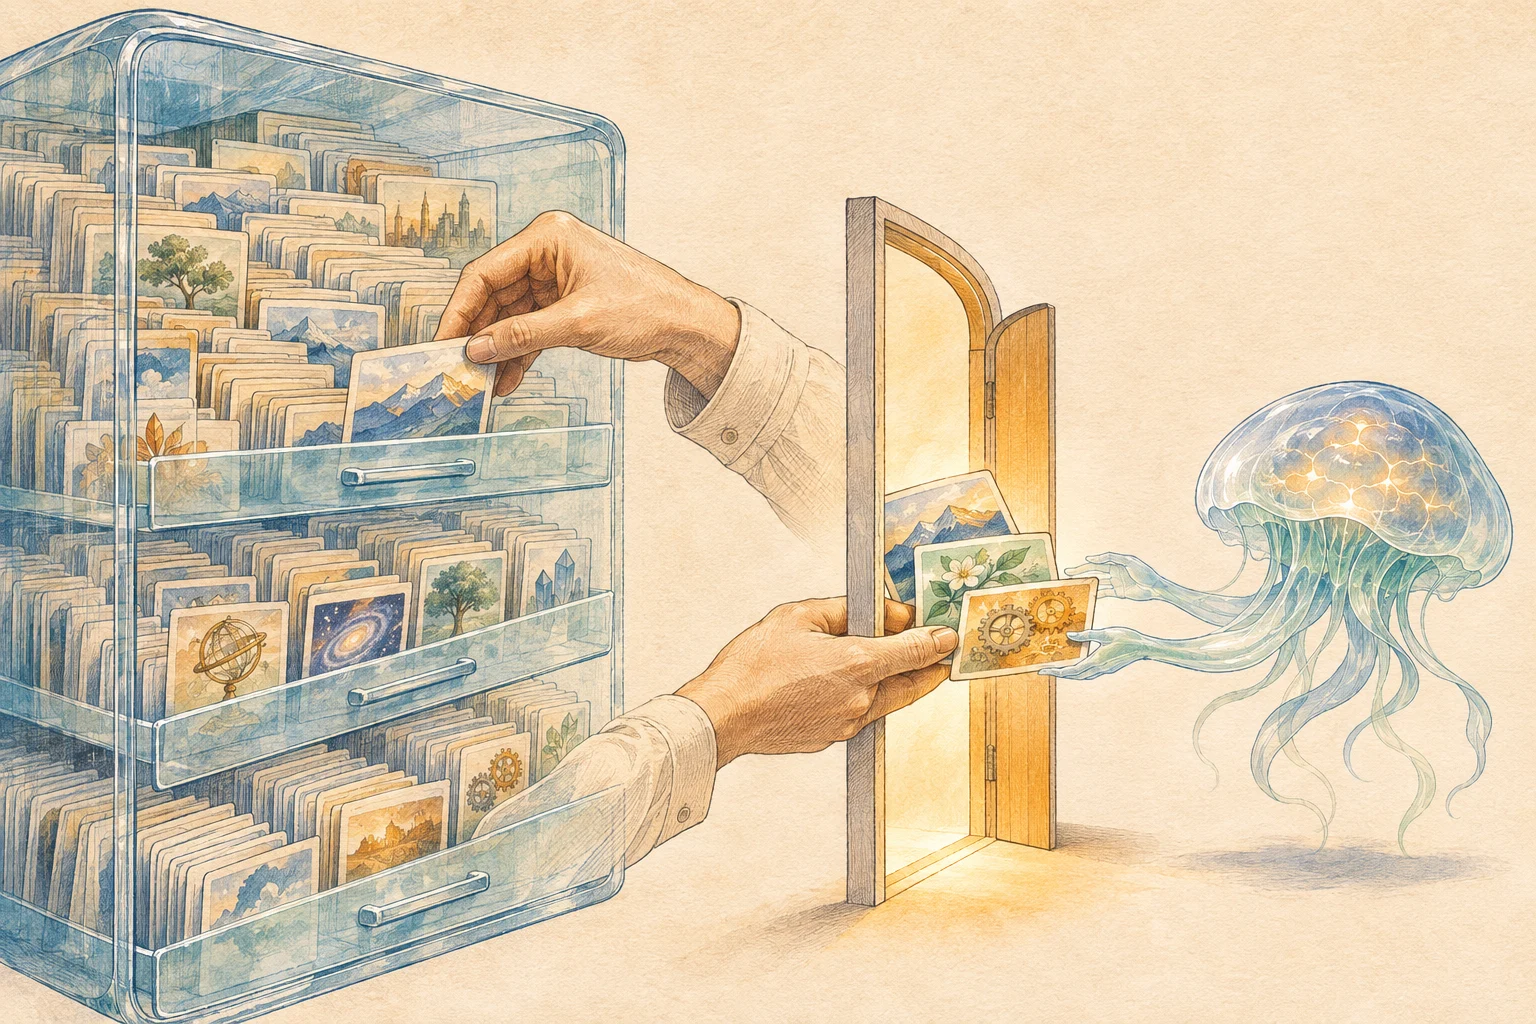
Três, a dificuldade do contexto mudou de "salvar" para "como usar nesta rodada"
No começo, ao fazer memória, minha atenção estava principalmente no lado da escrita: como extrair informações, como modelar os dados, como vetorizar o texto.
Depois, ao entrar em contato com algumas soluções que organizam o contexto em Markdown, percebi que elas tinham muito a oferecer em classificação e expressão da informação. Mas, entre as soluções que experimentei, alguns arquivos exigiam leitura obrigatória a cada rodada, enquanto outros eram carregados integralmente sob demanda.
Quando havia pouco material, isso era bem direto. À medida que o material foi aumentando, comecei a me preocupar: a cada vez só preciso de uma pequena parte da informação, mas tenho que carregar o arquivo inteiro antes.
Então, na refatoração, mantive os materiais básicos e dividi as informações mais detalhadas em entradas independentes, permitindo recuperação posterior por pergunta. Aqui, o banco de dados gerencia a pertinência, a classificação e o tempo das entradas, e o conteúdo textual expressa a semântica que o modelo precisa entender.
Mas, com a recuperação vetorial, os problemas não desapareceram sozinhos.
No início, a recuperação dependia principalmente da distância semântica. Depois fui adicionando filtro por escopo de negócio, peso de importância e decaimento temporal para parte das informações. Porque "ser muito parecido com a pergunta" e "ser adequado para a resposta atual" não são a mesma coisa.
Especialmente o tempo.
Eu costumava colocar apenas um "horário atual" no prompt do sistema, e só depois percebi que ele não consegue indicar quando cada mensagem histórica aconteceu. Olhando mais para a origem, mesmo que o banco tenha a data de criação, se o texto extraído perde o ano, o período ou a fase do material original, o modelo ainda tende a misturar coisas parecidas que aconteceram em momentos diferentes.
O ajuste posterior se dividiu em duas partes: as mensagens de conversa passaram a ter timestamp explícito; na extração de informações, as âncoras temporais confirmáveis no material são mantidas no corpo do texto, e os tempos que não podem ser determinados não são preenchidos.
Isso vem antes de simplesmente ajustar a fórmula de ordenação. Se a informação temporal se perde na extração, é difícil recuperá-la do nada na fase de busca.
Além disso, também tentei encapsular a recuperação de conhecimento como uma Tool, deixando o modelo decidir quando precisa complementar materiais, para evitar rodar mecanicamente todo o conjunto de recuperação a cada rodada.
Mas o Tool Call revelou outra fronteira: o modelo não consegue gerar de forma estável o ID do objeto de negócio atual. Esse ID já está no contexto de execução do sistema, e mesmo assim eu ainda pedia ao modelo para adivinhar de novo.
No fim, passei a injetar, antes da execução da ferramenta, os parâmetros já determinados no contexto atual. O modelo pode decidir se precisa recuperar e o que recuperar; já quem é o usuário atual, qual objeto está sendo operado e se há permissão de acesso devem ser determinados e validados pelo programa.
Depois de passar por esses problemas, minha compreensão de contexto passou de "coletar o máximo possível" para, aos poucos: manter as informações necessárias para a tarefa atual e fazê-las entrar no modelo na forma adequada.
Quanto a quanto cada mudança realmente melhorou o efeito, não tenho dados de avaliação suficientemente sistemáticos e não quero inventar uma porcentagem aqui. O que posso confirmar é que comecei a saber por qual cadeia investigar, em vez de ficar só olhando para a resposta final e ajustando o prompt.
Quatro, separar diretórios não significa estar realmente desacoplado
No passado, em projetos Web, eu estava muito acostumado a primeiro escrever o backend, depois embrulhar em uma interface HTTP e, por fim, expor para o frontend chamar. Este Agent inicialmente seguiu uma estrutura parecida, com as capacidades de negócio e o serviço Web muito próximos.
Depois, como o produto passou a interagir principalmente por IM, adicionei também uma CLI para executar operações de configuração, administração e diagnóstico. Nesse ponto, a camada de negócio continuar dependendo do framework Web já parecia estranho.
Então separei o Service, deixei ele carregar as capacidades de negócio e acesso a dados, e diferentes entradas passaram a chamá-lo.
Parece que já está desacoplado, certo? A realidade me deu outro soco.
Uma vez, ao rodar o comando de ajuda da CLI, o que apareceu foi a ajuda do framework Web.
A causa era que o módulo de comandos importava o Service, e o Service, no nível superior, importava o tipo Request do framework Web. Originalmente era só uma anotação de tipo, mas em tempo de execução trazia o framework inteiro e afetava o parsing dos argumentos de linha de comando.
A correção não era complicada: dependências puramente de tipo foram movidas para TYPE_CHECKING, a fase de registro de comandos passou a ser o mais leve possível, e os módulos necessários só são carregados na execução real.
Mas esse pequeno detalhe me fez perceber que as setas de dependência no diagrama de arquitetura, no fim, precisam se concretizar no import e na inicialização dos módulos. Um Service que parece limpo, se importá-lo traz o framework, lê parâmetros ou inicia conexões externas, ainda vai dar problema quando for chamado por outra entrada.
Depois, para simplificar a configuração do usuário, tentei colocar parte da capacidade de dados no remoto. Onde antes se pegava um objeto ORM, agora era preciso consumir uma estrutura de retorno explícita; as operações de banco espalhadas pela entrada e pelo Graph também precisavam continuar sendo recolhidas no Service.
Adicionei uma camada de distribuição unificada: no modo local, chama o Service; no modo remoto, chama a API HTTP correspondente. A serialização também é tratada nessa fronteira, para evitar que conversões de enums, objetos de tempo e parâmetros opcionais fiquem espalhadas por todo lado.
Por exemplo, um parâmetro de consulta com valor padrão: passar None em uma função Python é natural, mas na codificação de query HTTP pode simplesmente dar erro. A correção deve ficar na fronteira da requisição, preservando ao mesmo tempo valores com significado real como 0 e False; também não se pode simplesmente apagar um null explícito no corpo JSON da requisição.
Nada disso é algoritmo complexo, mas decide se "uma função que pode ser chamada localmente" pode se tornar uma interface remota confiável.
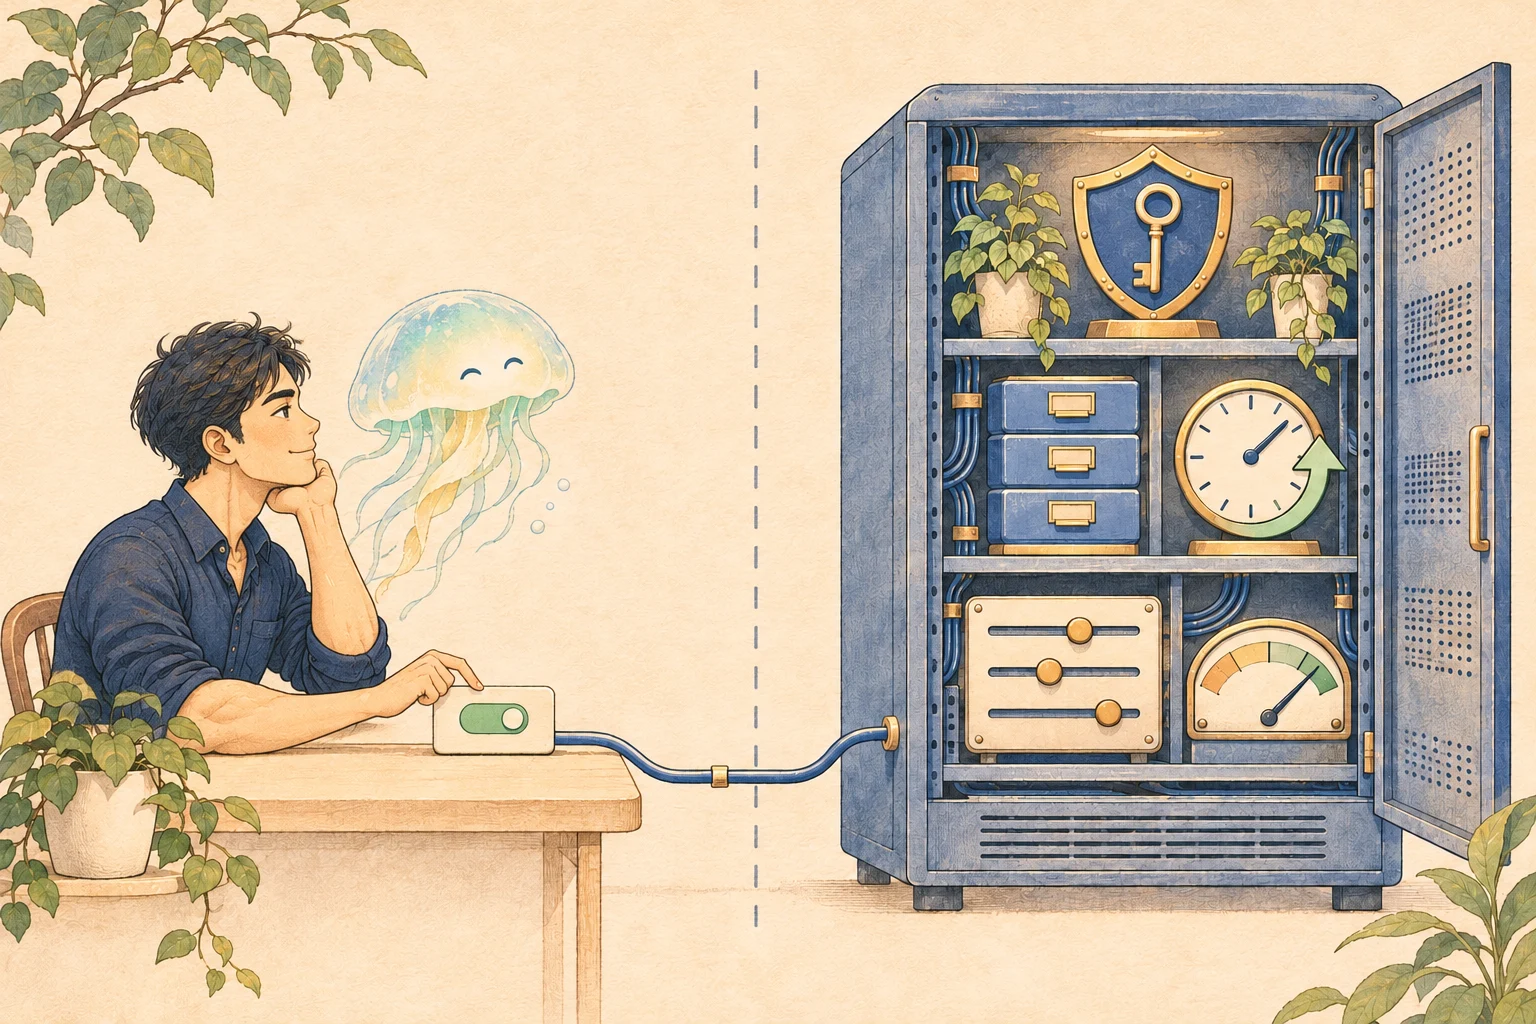
Cinco, o usuário configura um banco de dados a menos, e o sistema assume mais um conjunto de responsabilidades
Fazer a CLI e a entrada por IM foi, no início, para reduzir o desenvolvimento de um frontend independente e também para permitir que o usuário interagisse em um lugar familiar.
Mas, ao encadear o processo de instalação, percebi que eu só tinha eliminado o frontend; o usuário ainda precisava preparar banco de dados, configuração de modelo e configuração de bot. O código rodava, mas ainda havia um longo caminho até o usuário querer usar.
Por isso tentei fazer o servidor assumir o acesso ao banco de dados, reduzindo o fardo de o usuário criar o banco por conta própria.
A primeira restrição era clara: não se pode, por conveniência, enviar as credenciais de conexão do banco compartilhado para o cliente. Operações comuns de dados podem ser atendidas por uma API autenticada, mas o checkpoint do fluxo de trabalho depende da conexão com o banco, e ele não ganha automaticamente capacidade de armazenamento remoto só porque adicionei uma rota HTTP.
Na época, a solução foi manter dois comportamentos: o modo local continua usando PostgreSQL para persistir o checkpoint; o modo compartilhado experimental passou a usar memória do processo.
O custo também era claro: após reiniciar o processo, essa parte da memória de curto prazo no modo compartilhado se perde.
Não resolvi esse problema completamente, apenas aceitei uma degradação em troca de uma forma de execução que não expõe a conexão com o banco ao cliente. Isso também não significa que o checkpoint nunca possa ser remoto; só que aquela camada de distribuição da época não cobria isso, e o custo de continuar abstraindo já ultrapassava o objetivo daquela rodada.
O problema mais incômodo ainda estava por vir.
Alguns Services que parecem ser de "sincronização de dados" na verdade chamam o modelo internamente. Ao movê-los para o servidor, de quem deveria ser a configuração de modelo usada? Como passar a configuração do usuário? Quem assume o custo da chamada?
Antes, em uma máquina única, banco de dados, configuração de modelo e ambiente de execução estavam no mesmo lugar, e esses problemas eram facilmente ignorados. Depois de cruzar a rede, cada item precisa ser respondido de novo.
O estado de login também. Para reduzir interrupções de tarefas em segundo plano por expiração de token, cheguei a adotar um modo sem tempo de expiração. Mas os problemas de rotação, revogação e governança de invalidação que isso deixa continuam existindo; não se pode dizer que a autenticação está bem projetada só porque o fluxo principal continua rodando.
No fim, embora parte da cadeia do modo compartilhado já estivesse funcionando, ainda escondi a entrada de configuração pública. Se a propriedade da configuração de modelo e a fronteira de execução em nome do usuário pelo servidor não estavam bem resolvidas, não se deveria deixar o usuário tratá-la como uma opção já pronta.
Essa também foi uma mudança minha no nível de produto: reduzir o custo de uso significa que alguém precisa assumir a complexidade antes entregue ao usuário. Se o usuário não precisa mais configurar o banco de dados, o servidor precisa absorver as permissões, configurações e responsabilidades de execução correspondentes. Um "Easy Mode" está longe de ser apenas mostrar menos campos de entrada.
Seis, uma falha no serviço de prompts me fez repensar as dependências de execução
Houve ainda uma lição que quase não tem relação com a capacidade do modelo.
Para facilitar o ajuste, coloquei os prompts em uma plataforma externa e os buscava em tempo real durante a execução. Alterar o prompt não exigia novo deploy, e a experiência de desenvolvimento era realmente boa.
Então o serviço da plataforma falhou.
Eu não tinha backup local nem tinha projetado um fallback para falha de leitura, e as cadeias que envolviam prompts caíram todas de uma vez. O serviço externo se recuperou cerca de dois dias depois, mas esses dois dias foram suficientes para eu perceber: eu tinha transformado uma ferramenta de conveniência de desenvolvimento em uma dependência rígida de execução.
A lição que isso me trouxe é bem concreta. Embora o prompt seja um trecho de texto, no sistema ele carrega lógica de execução real; sua versão, backup e disponibilidade precisam ser tratados com seriedade. Gerenciá-lo remotamente não faz essas responsabilidades desaparecerem.
Durante o desenvolvimento posterior, também comecei a consolidar em Skills os requisitos de colaboração que se repetiam: fazer controle de qualidade após alterações, registrar mudanças, sincronizar a documentação do Graph e escrever as correções de volta nas regras.
Esses procedimentos não substituem os testes, nem garantem que o Agent execute corretamente todas as vezes. Mas, pelo menos, quando o mesmo tipo de omissão voltar a ocorrer, terei a chance de modificar as regras que são continuamente consumidas, em vez de apenas dar mais um lembrete.
Considerações finais
Olhando para trás, esta reescrita não foi algo que aconteceu em um único dia, quando entendi todos os problemas de uma vez e desenhei uma nova arquitetura de uma só vez.
Primeiro interpretei mal o checkpoint, depois redesenhei o estado; primeiro busquei entradas de granularidade fina, depois voltei ao significado que o downstream realmente precisa; primeiro separei a camada de negócios e removi entradas desnecessárias, e mais tarde, por causa do novo modo de implantação, adicionei de volta o serviço HTTP. Novos problemas surgem constantemente, e as escolhas feitas anteriormente também são reexaminadas.
Não me preocupo mais tanto em saber "se escolhi o framework errado lá no início". O que realmente me fez dar voltas foi não ter clareado algumas fronteiras mais básicas: o que precisa ser persistido, o que precisa entrar no modelo, quais parâmetros são decididos pelo programa e quais responsabilidades uma capacidade leva consigo quando muda de local de execução.
Agora, quando começo a escrever uma nova funcionalidade, gasto um pouco mais de tempo do que antes me perguntando sobre essas questões. Elas não necessariamente me fazem acertar de primeira, mas me fazem escrever menos código que parece já estar pronto e que, ao mudar de cenário, precisa ser derrubado e refeito.
Quanto a esta reescrita, o resultado que mais gostaria de deixar são, provavelmente, essas perguntas que continuarão a influenciar como escrevo código daqui para frente.